
xAI正式发布Grok 4.7,还是没赶上这一代顶尖模型
美国当地时间9月21日,埃隆·马斯克旗下的xAI正式发布了新一代旗舰模型Grok 4.7。此前,xAI已先后至少5次推迟了该模型的发布时间。
作为xAI至今为止能力最强的编码与知识工作模型,Grok 4.7的参数量提升至2.1万亿,相比上一代Grok 4.6的 1.5万亿增长了约40%。在保持输入每百万Token 2美元、输出每百万Token 6美元(与Grok 4.6一致)的价格前提下,实现了输出速度与长时程推理能力的明显提升。
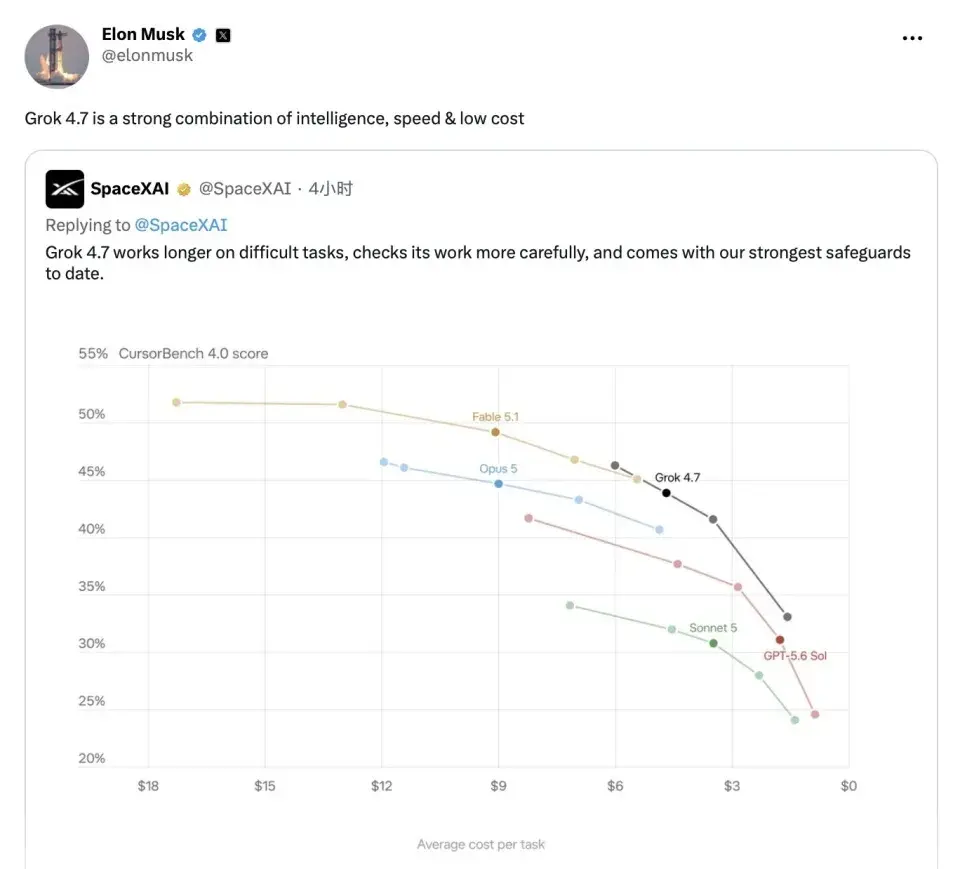
马斯克发帖截图
对于这次发布,马斯克在X上评价称,Grok 4.7实现了"智能、速度与低成本的强力结合"。
即日起,Grok 4.7已在Cursor、Grok应用、Grok Build中正式上线,同时也已通过Grok API、第三方编码工具框架以及主流云平台全面开放供开发者与企业使用。
然而,科技媒体与行业分析师的反应却相对温和甚至克制。多家媒体指出,尽管 Grok 4.7相比Grok 4.6有所进步,但在顶尖模型纷纷跨越新门槛的当前阶段,它的登场更像是一场"反响平平的晚到派对",依然没能打破由Anthropic Fable 5.1和OpenAI GPT-6 Astra占据的第一梯队格局。
01 跑分比GPT 5.6强,但够不到最前沿
从主要跑分轴上来看,模型的整体水平是在上一代OpenAI和Anthropic旗舰和这一代旗舰之间。
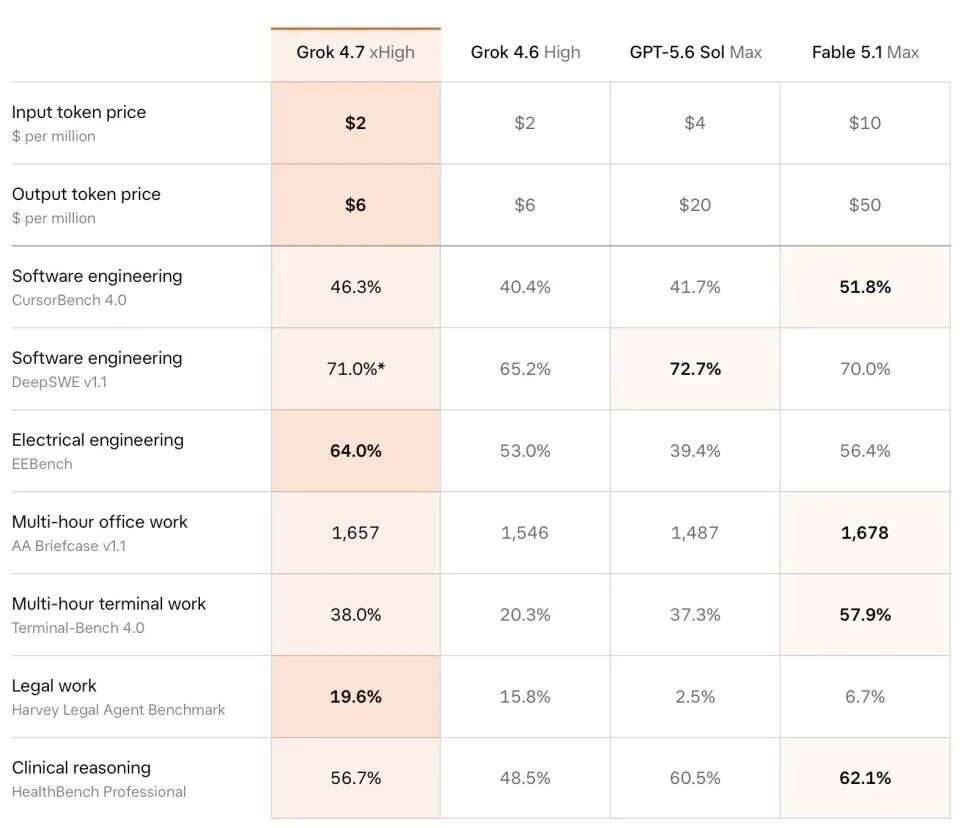
在多项核心基准测试中,Grok 4.7表现出全面超越前代的进阶实力。在软件工程基准 CursorBench 4.0中取得46.3%得分,虽低于Fable 5.1 Max(51.8%),但超越了 GPT-5.6 Sol Max(41.7%);在DeepSWE v1.1(高努力模式)和AA Briefcase v1.1(多小时办公)测试中,得分分别达到71.0%与1,657分,均优于前代及部分同级竞品,逼近第一梯队顶尖模型。
然而,Grok 4.7 依然栽在了二线模型普遍和一线模型差异最大的Terminal-Bench 4.0上。
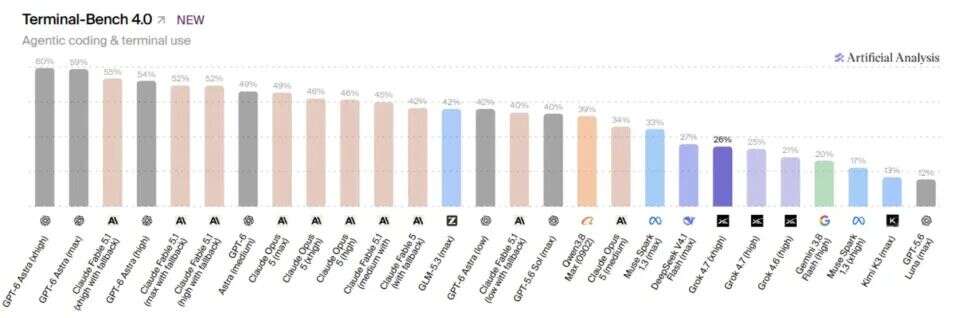
在多小时终端工作基准Terminal-Bench 4.0测试中,Grok 4.7得分为38.0%,略高于GPT-5.6 Sol Max的37.3%。但远低于Anthropic Claude Fable 5.1的57.9%,甚至不如GLM、Qwen、DeepSeek最新的模型。
在具体垂直领域的Benchmark上,Grok 4.7则下了不少功夫,取得的成绩还不错。
在电气工程基准EEBench(64.0%)与法律基准Harvey Legal Agent(19.6%)测试中均取得领先,超越了前代及Fable 5.1 Max、GPT-5.6 Sol Max等主要竞品;在临床推理基准HealthBench Professional中得分达56.7%,较前代(48.5%)明显提升,但仍落后于GPT-5.6 Sol Max(60.5%)与Fable 5.1 Max(62.1%)。
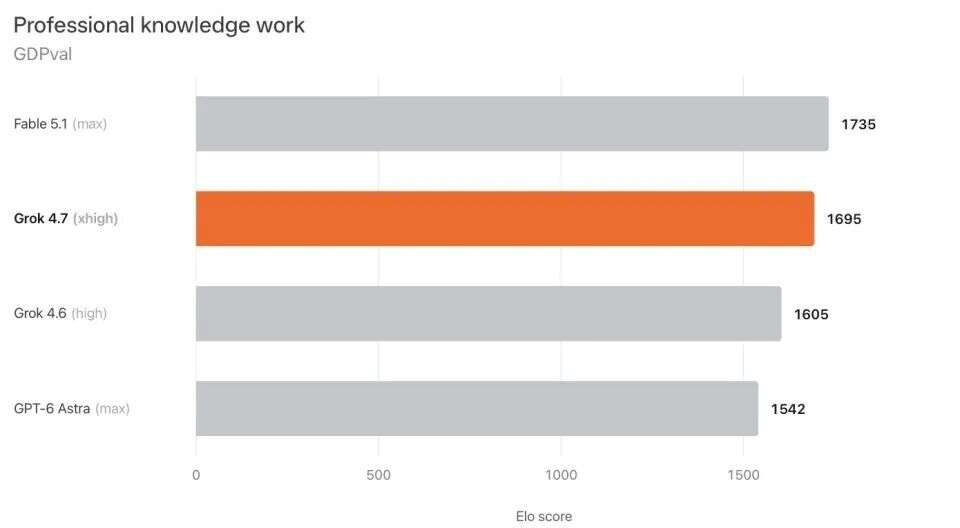
在模拟专业人员日常文档与演示文稿创建的GDPval评估中,Grok 4.7取得了1,695的Elo得分,超越前代Grok 4.6的1,605与GPT-6 Astra Max的 1,542,仅次于Claude Fable 5.1的1,735。
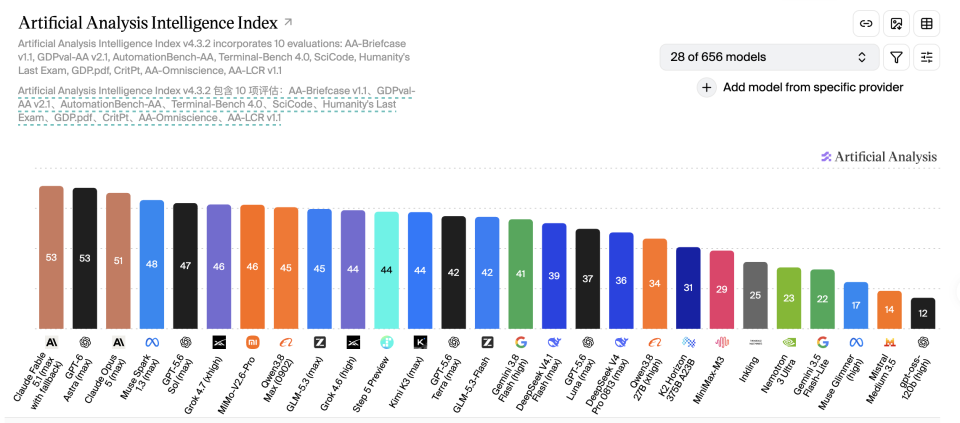
综合来看,在Artificial Analysis综合智能指数上,Grok 4.7取得了46分,在第二梯队上名列第一。
02 训练层面,进步有限
就目前发布页的情况看,Grok 4.7整体在训练期间创新不太多。
比较明确的策略有,强化学习向高难复杂任务倾斜,采用更长的强化学习(RL)训练阶段,大幅加权了需要数小时才能完成的复杂长任务。
原生集成Grok Bot Harness,首次将模型与底层的Grok Bot工具运行环境(Harness)进行原生深度融合训练。
注重自我验证与长上下文管理,模型在自我结果验证与长序列上下文保持上的能力得到加强,能够更及时地在错误积累前发现并纠正偏误。
这些都是现在前沿模型训练的标准操作。
除此之外,Grok 4.7还在训练阶段引入SpaceX独家工程数据,训练集融入了来自SpaceX的星链(Starlink)卫星遥测数据、制造记录与工程故障日志。
这也是为什么它在工程Benchmark上表现亮眼的原因,因为自家有数据。
03 便宜这张牌,也不好打
从当下来看,价格可能是它相对第一梯队的主要优势。但这个优势其实非常脆弱。
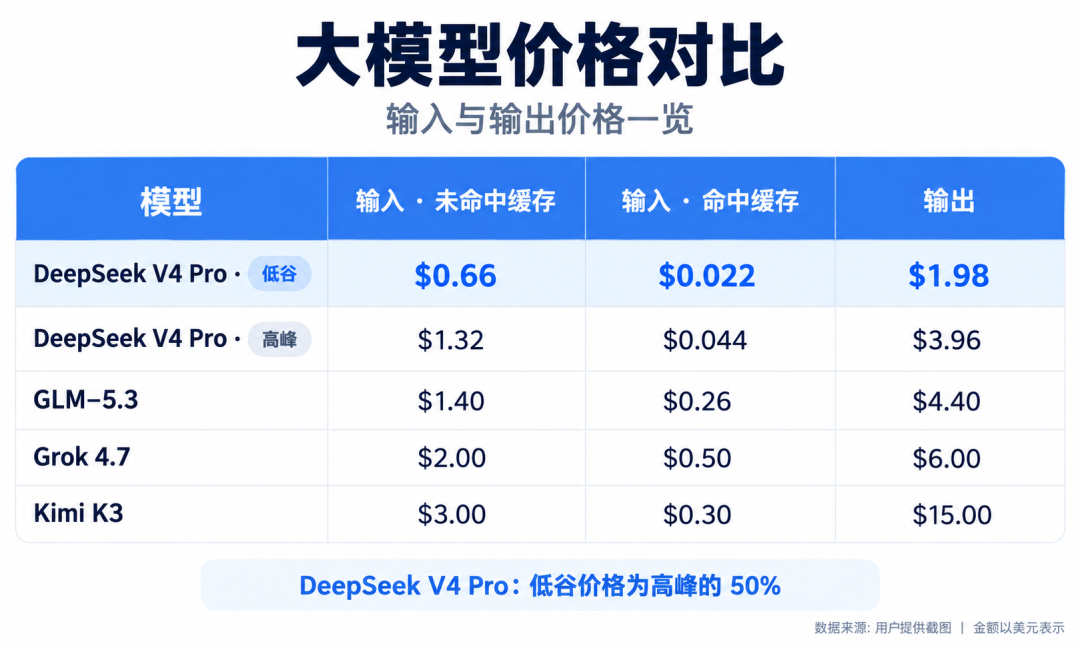
Grok 4.7的API基础定价为输入每百万Token 2美元、输出每百万Token 6美元。相比之下,GPT-5.6 Sol Max输入价格为每百万4美元、输出价格为每百万20美元;Fable 5.1 Max输入价格达每百万10美元、输出价格则是每百万50美元。
这意味着,Grok 4.7的Token成本仅为GPT-5.6 Sol Max的三分之一到二分之一,仅为Fable 5.1 Max的五分之一到八分之一。
但相对于实际能力与Grok 4.7相当的国产模型,这个价格其实整体优势不算大。除了相对于Kimi K3有一些明显价格优势,相对其他模型而言依然很贵。
这就使Grok 4.7的定价定位略显尴尬。
而且Grok 4.7 本身也有非常严重的过度思考问题。
科技媒体The New Stack在分析中特别指出,由于Grok 4.7在长推理阶段输出了更多Token(平均每项任务约8.1万个Token,高于Grok 4.6的3.6万个),虽然单价较低,但实际复杂任务中的单次总开销可能会因Token输出膨胀而有所上升。
04 马斯克没能fake it until make it
"Fake it until you make it"(先装模作样,直到弄假成真),马斯克一直是这句话最忠实的践行者,但在这个刚刚发布的 Grok 4.7 上,他的预期管理魔法似乎失灵了。
按照马斯克一贯的营销节奏,Grok 4.7 的预热原本也是冲着秒杀全场去的。
7 月底,他先抛出了硬指标:2.1 万亿参数,规模比上一代大 40%。除了响应速度稍慢,其他方面都会更好。到了 8 月中旬,他直接在社交平台上放话:4.7 将超过市面上所有模型。为了增加说服力,他甚至搬出了 SpaceX 的独家训练数据背书,表示如果在真实工程能力上比不过别人,他"会很吃惊"。
但大模型的玄学就在于,哪怕是马斯克,也得向微调低头。
9 月初,原本承诺的上线时间变成了"十天后";到了 9 月 11 日,期限又被推迟成了"还得再煮几天"。马斯克的解释倒是很实在:训练时对长回答的惩罚太狠了,导致模型遇到本能解出的难题也提前罢工,自我检查也漏洞百出。
到了 9 月 14 日,官方的"降调"正式开始。马斯克在发帖时话锋一转,把 4.7 的对标对象从"超越所有"默默改成了"大致相当于 Opus 5.0,而不是 5.1",并承认多模态能力还得继续修补。
更有意思的是,他顺手把那些没能兑现的承诺,打包递给了未来的版本:4.8 会有明显提升,4.9 大概能摸到 Astra 或者 Fable 的水平,至于那个"比所有模型都强"的究极形态,可能得等 Grok 5 了。曾经斩钉截铁的"会超过",变成了满屏的"大概"和"可能"。
等到 9 月 21 日正式发布时,马斯克已经完全接受了现实。
在宣发上,他不再提什么全面领先,而是坦承公司在智能体编程方面排在 Anthropic 和 OpenAI 后面。如今 Grok 4.7 的核心卖点,已经变成了四个字:便宜好用(速度快、成本低,适合日常干活)。